Sinais de qualidade para testar uma funcionalidade de IA
Um quadro prático para definir casos de avaliação, rever resultados, medir o comportamento do sistema e decidir se uma funcionalidade de IA está pronta para mudar.
Supermoon Software / 20 de outubro de 2026 / 6 min de leitura
Uma funcionalidade de IA pode parecer convincente numa demonstração preparada, embora continue a ser difícil de avaliar enquanto produto. A demonstração mostra aquilo que a equipa selecionou, nas condições que a equipa organizou. A avaliação coloca uma questão diferente: que provas sustentariam a decisão de lançar, rever, restringir ou remover a funcionalidade?
Uma avaliação útil começa antes de alguém escolher uma métrica. A equipa precisa de definir a tarefa, os limites aceitáveis e as consequências de uma falha. A partir daí, pode reunir casos representativos, combinar verificações automatizadas com uma análise humana estruturada e monitorizar o fluxo completo do produto, em vez de tratar um resultado gerado como se fosse toda a experiência.
Começar pela decisão sobre o produto
A avaliação deve identificar a decisão que pretende fundamentar. Um objetivo abrangente, como medir a qualidade, deixa demasiado espaço para interpretação. Um objetivo prático identifica a tarefa, as condições relevantes e a ação que a equipa poderá realizar depois de analisar os resultados.
- Relevância para a decisão: Especificar se o resultado irá orientar o âmbito do lançamento, as alterações à interface, a seleção do modelo ou medidas de proteção adicionais.
- Tarefa prevista: Descrever aquilo que a funcionalidade deve ajudar a concretizar sem depender de uma implementação técnica específica.
- Falha aceitável: Separar os pequenos inconvenientes dos erros que exigem bloqueio, correção ou análise humana explícita.
- Limite operacional: Registar os idiomas, os tipos de dados de entrada, as áreas temáticas e os fluxos de trabalho incluídos na avaliação.
Este enquadramento impede que um resultado agregado favorável esconda uma falha relevante para o produto. Se, por exemplo, as afirmações sem fundamento forem inaceitáveis numa ferramenta de apoio à investigação, uma redação fluente não poderá compensar um fraco alinhamento com as fontes. Por conseguinte, a avaliação correspondente deve testar se as afirmações geradas podem ser associadas ao material fornecido, e não apenas se a resposta parece cuidada.
Criar um conjunto de avaliação a partir de condições reais
Um conjunto de avaliação é uma coleção mantida de dados de entrada, propriedades esperadas e notas de análise utilizada para testar repetidamente uma funcionalidade. Deve incluir casos habituais, casos difíceis e dados de entrada que se encontrem fora do limite previsto. O objetivo não é prever todos os pedidos possíveis, mas revelar as condições relevantes para a atual decisão sobre o produto.
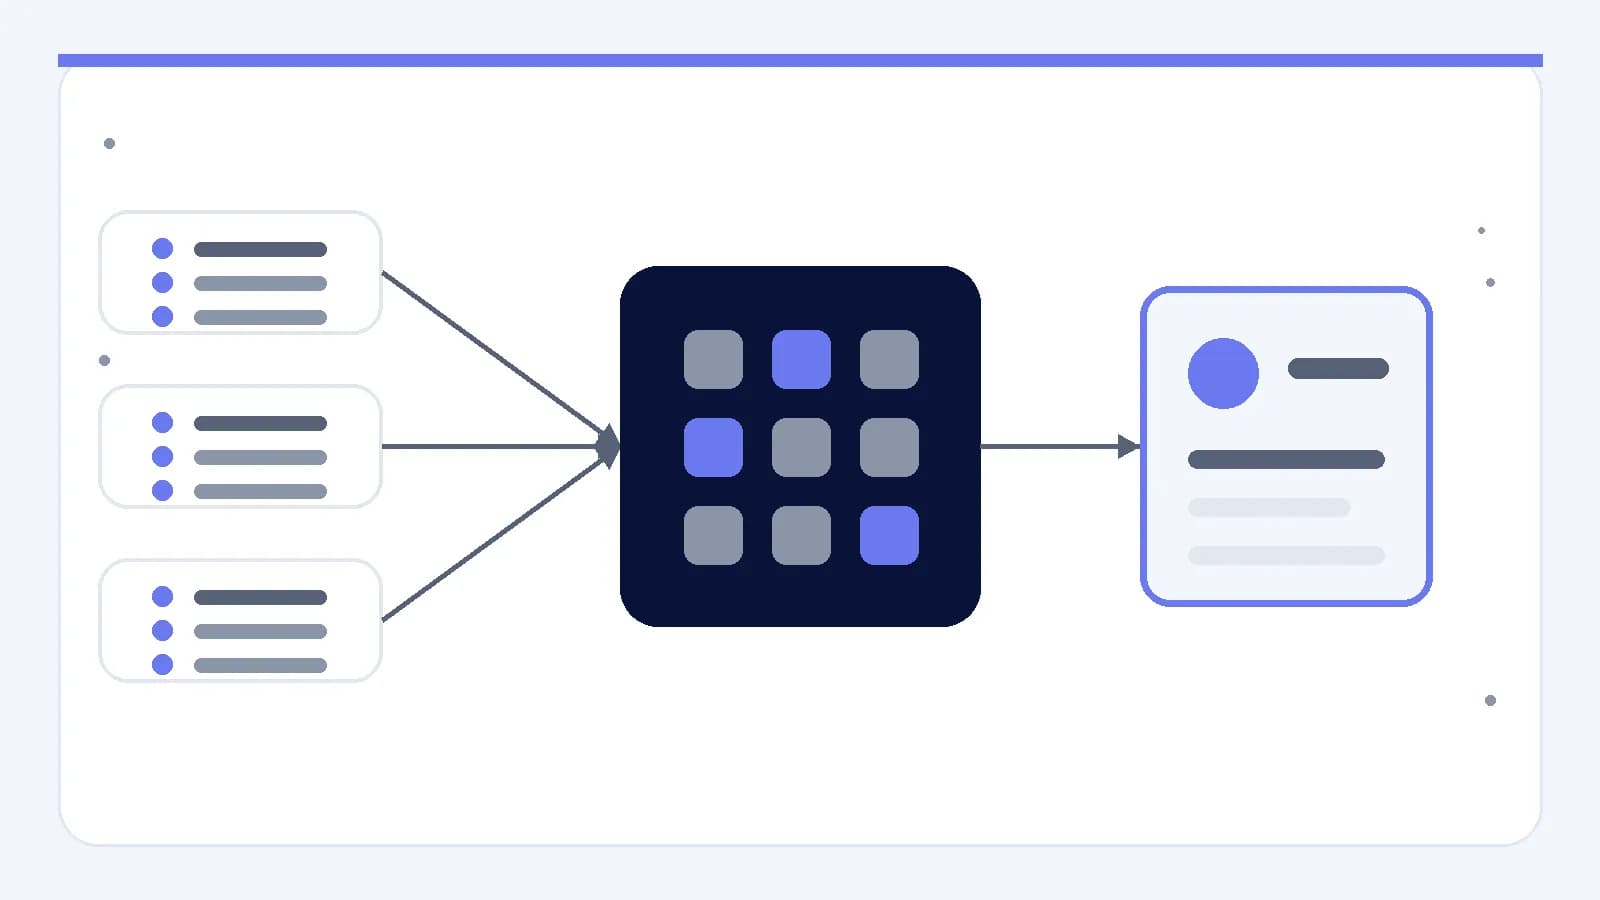
Um conjunto útil pode recorrer a exemplos internos aprovados, cenários construídos deliberadamente e, quando adequado, material operacional expurgado de dados sensíveis. Cada caso deve explicar por que motivo existe e o que deve ser inspecionado por quem realiza a análise. Se um exemplo depender do contexto, esse contexto deve constar da definição do caso, em vez de ficar dependente da memória de quem o analisa. O material sensível deve ser excluído ou tratado de acordo com as regras de dados estabelecidas para o produto.
Utilizar sinais que descrevam falhas diferentes
Nenhum sinal isolado representa a qualidade do produto. As verificações automatizadas podem identificar propriedades que sejam fáceis de definir de forma consistente, enquanto a análise humana pode avaliar o significado, a utilidade e a ambiguidade. A equipa deve escolher cada sinal porque este corresponde a um risco conhecido do produto, e não porque seja conveniente calculá-lo.
- Conclusão da tarefa: O resultado cumpriu a instrução específica e preservou as restrições exigidas?
- Fundamentação: As afirmações relevantes podem ser associadas às informações fornecidas para esse caso?
- Cumprimento do formato: O resultado seguiu a estrutura necessária para o fluxo de trabalho envolvente?
- Qualidade da recusa: Quando o pedido estava fora do âmbito, a funcionalidade evitou prosseguir e apresentou um passo seguinte adequado?
- Desempenho do sistema: O tempo de processamento, o tratamento de falhas e a utilização de recursos mantiveram-se dentro dos limites operacionais definidos pela equipa?
Uma pontuação deve preservar pormenores suficientes para explicar o que falhou. A fundamentação, por exemplo, não deve ser combinada com a qualidade da escrita se estes sinais conduzirem a correções diferentes. Se uma implementação apresentar um valor de confiança, a equipa deve verificar o que esse valor representa antes de o utilizar. O valor de confiança não deve ser tratado como substituto de provas associadas à tarefa.
Tornar a análise humana repetível
A análise humana torna-se mais útil quando as pessoas responsáveis aplicam os mesmos critérios escritos ao mesmo material. Uma grelha de avaliação é um conjunto de categorias de apreciação definidas, com exemplos de resultados aceitáveis e inaceitáveis. Deve descrever propriedades observáveis, em vez de se limitar a perguntar se uma resposta parece boa.
- Escrever um critério breve para cada risco do produto, incluindo as provas que a pessoa responsável pela análise deve examinar.
- Testar a grelha com uma amostra partilhada e discutir os casos em que as pessoas responsáveis pela análise a interpretam de forma diferente.
- Rever a linguagem ambígua e, em seguida, registar o raciocínio subjacente às apreciações difíceis para referência futura.
- Analisar os casos sem rótulos de implementação desnecessários quando esses rótulos possam influenciar a apreciação.
- Encaminhar os desacordos com consequências relevantes para uma decisão específica sobre o produto, em vez de os eliminar através de uma média.
Uma taxonomia de falhas, ou seja, um conjunto consistente de categorias de falhas, ajuda a associar as conclusões da análise ao trabalho sobre o produto. As categorias podem distinguir informações em falta, conteúdo sem fundamento, instruções ignoradas e problemas de recuperação da interface. Os rótulos exatos devem refletir a funcionalidade. Só são úteis quando a equipa os consegue associar a uma pessoa responsável, a uma investigação ou a uma decisão sobre o âmbito.
Avaliar o ciclo completo do produto
O texto, a imagem ou a ação gerados são apenas uma parte da funcionalidade. A avaliação deve abranger também a preparação dos dados de entrada, a obtenção de material de apoio, os controlos da interface, a comunicação do estado, a recuperação de erros e qualquer etapa de aprovação humana. Os componentes relevantes dependem da implementação e devem ser verificados como parte do plano de testes.
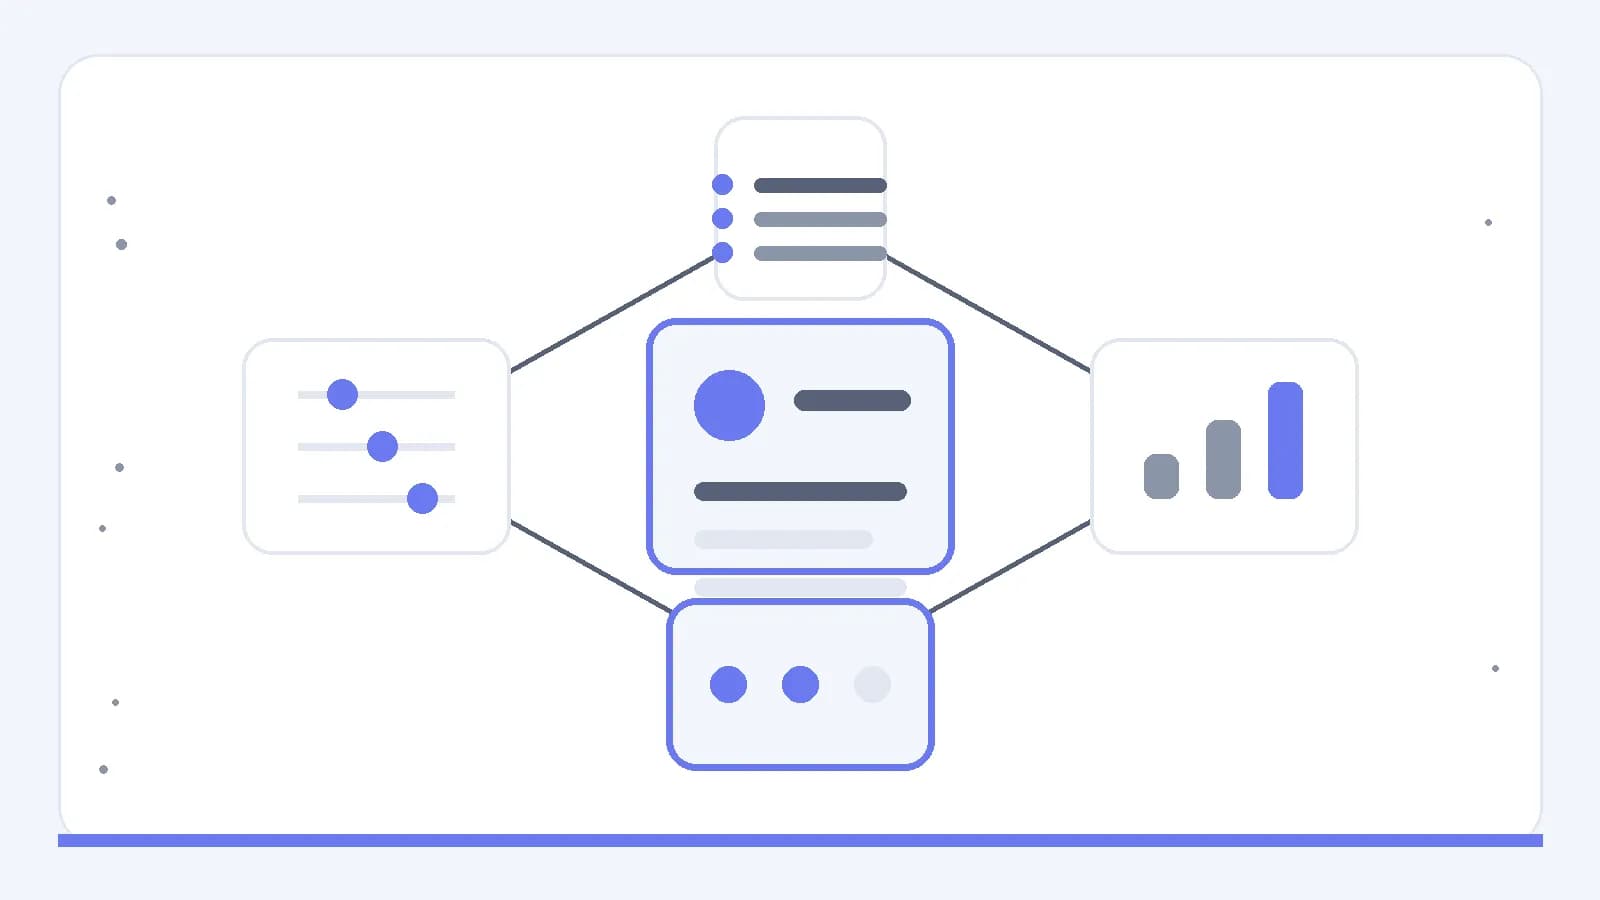
- As verificações dos dados de entrada devem abranger a falta de contexto, as instruções contraditórias e o material fora do limite suportado.
- As verificações do estado devem confirmar que a interface representa a espera, a falha e a conclusão de acordo com o fluxo previsto.
- Os controlos humanos devem testar se a análise, a correção, o cancelamento e a reversão estão disponíveis quando o produto os exige.
- As verificações de alterações devem procurar regressões, ou seja, casos anteriormente aceitáveis que se tornam inaceitáveis após uma atualização.
Esta visão do sistema também esclarece onde deve ser aplicada uma correção. Um resultado fraco pode exigir orientações mais claras para os dados de entrada, uma melhor seleção das fontes, um âmbito mais restrito ou uma etapa de aprovação adicional, em vez de uma alteração ao modelo. Registar a camada suspeita impede que a avaliação reduza todos os problemas a uma única pontuação do resultado.
Transformar as conclusões em limites de lançamento
A análise final deve associar as provas a escolhas explícitas sobre o produto. A equipa pode identificar os casos que têm de passar, as falhas que exigem controlo humano e as condições que permanecem fora do âmbito suportado. Os resultados devem ser guardados juntamente com as definições dos casos, a grelha de avaliação e a configuração relevante da implementação, para que as avaliações posteriores continuem a ser interpretáveis.
Por conseguinte, um quadro prático reúne uma decisão definida, um conjunto de avaliação mantido, sinais de qualidade distintos, uma análise humana repetível e verificações em todo o ciclo do produto. O objetivo não é produzir uma pontuação perfeita. O objetivo é tornar clara a decisão seguinte: lançar dentro de um limite declarado, rever uma camada específica, adicionar um controlo ou reter a funcionalidade até que uma falha significativa seja compreendida.