Cómo evaluar funciones de IA más allá de una demo
Las demos de IA muestran posibilidades, no una calidad de producto fiable. Este marco convierte tareas previstas, pruebas, revisión humana y límites de lanzamiento en señales prácticas.
Supermoon Software / 28 de julio de 2026 / 6 min de lectura
Una demo pulida responde a una pregunta concreta: ¿puede una función de IA producir un resultado convincente en condiciones seleccionadas? No demuestra cómo gestiona la función las solicitudes ambiguas, el material de origen deficiente, las entradas poco habituales o las tareas en las que una respuesta incorrecta tiene consecuencias relevantes.
Una evaluación útil comienza con la decisión o la tarea para la que se ha diseñado la función. A continuación, los equipos de producto pueden recopilar casos de prueba representativos, definir señales de calidad observables y decidir dónde sigue siendo necesario el criterio humano. El objetivo no es demostrar que un modelo posee una inteligencia general. El objetivo es determinar si un diseño de producto específico se comporta de forma aceptable dentro de unos límites establecidos.
Define el cometido antes de juzgar el resultado
Empieza con una descripción concreta del cometido de la función. «Generar un resumen» es demasiado amplio para evaluarlo de manera coherente. «Producir un resumen revisable que conserve las decisiones identificadas, las preguntas sin resolver y las referencias a las fuentes» ofrece criterios más claros a quienes realizan la revisión. La descripción también debe indicar qué no debe inferir, omitir ni presentar como resuelto la función.
- La decisión o acción que el resultado pretende respaldar
- La información que debe seguir siendo visible, rastreable o inalterada
- Los errores que exigirían una corrección, un rechazo o una derivación
- Las condiciones en las que la función debería negarse a continuar o solicitar una aclaración
Estos límites convierten la evaluación en una cuestión de producto, en lugar de en un espectáculo de rendimiento. También revelan si el componente de IA es esencial para la tarea o simplemente práctico. Si quienes revisan los resultados no pueden describir un resultado aceptable sin referirse a lo impresionante que parece, el equipo necesita una explicación más precisa del cometido.
Crea un conjunto de evaluación basado en condiciones reales
Un conjunto de evaluación es una colección mantenida de entradas que se utiliza para examinar una función de manera repetida. Cada caso de prueba debe incluir la entrada, el contexto relevante, las características aceptables y los motivos de preocupación conocidos. El conjunto puede incluir ejemplos rutinarios, material incompleto, instrucciones contradictorias y casos cercanos al límite propuesto para el producto.
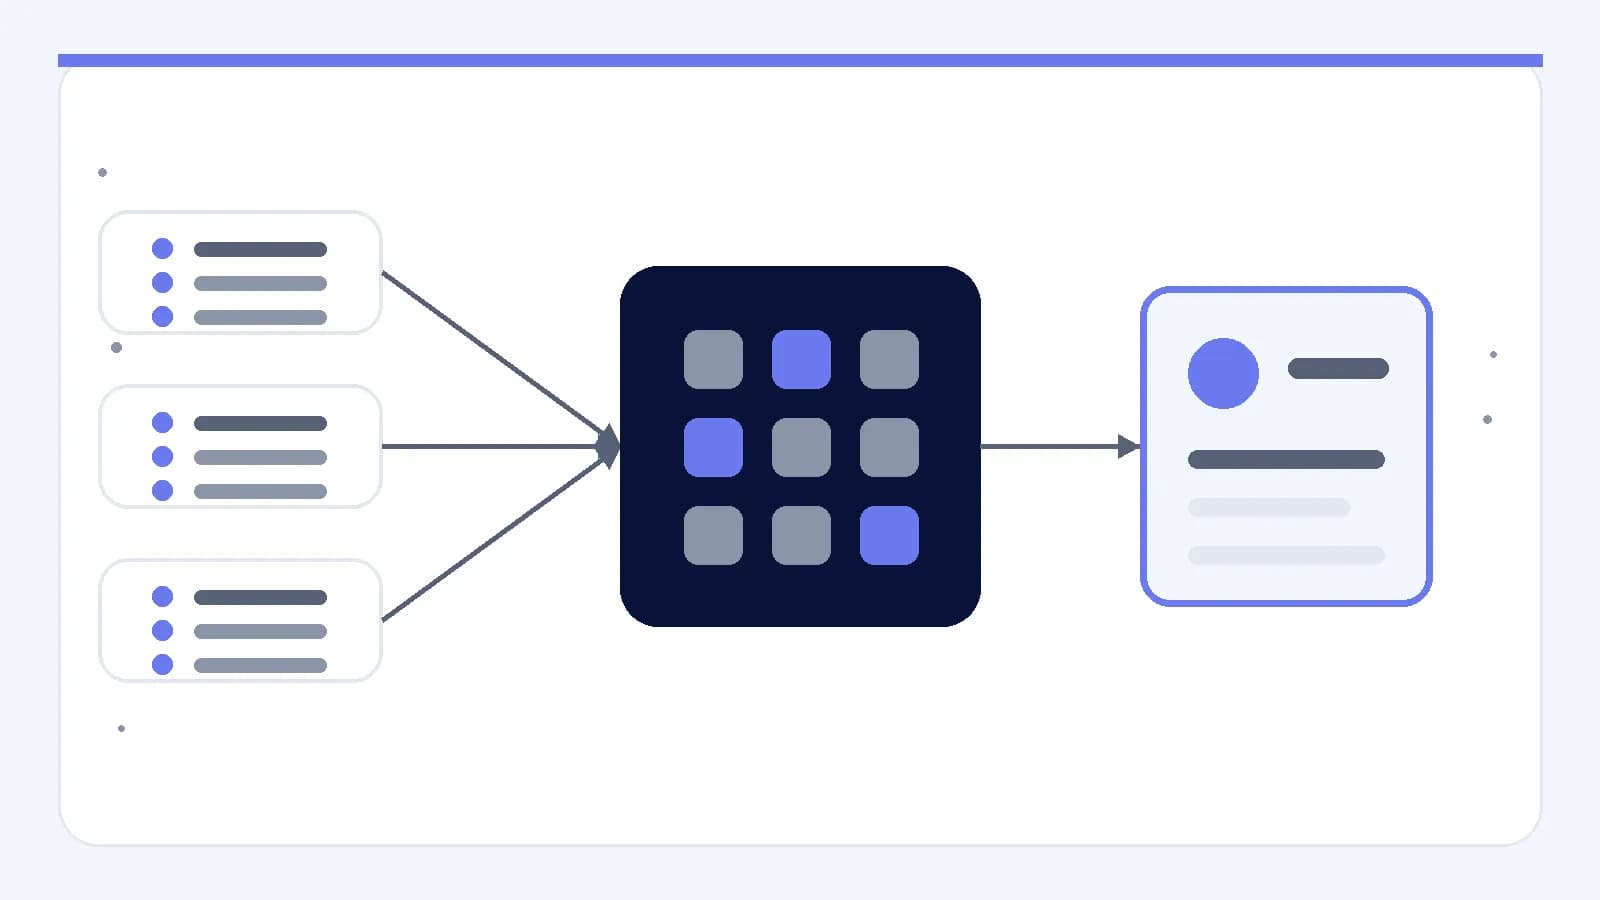
Una matriz de evaluación, es decir, una vista estructurada que conecta las condiciones de entrada con los criterios de revisión, puede revelar carencias de cobertura. En las integraciones con sistemas externos, el equipo debe verificar las interfaces disponibles, los formatos de datos, los permisos y las respuestas ante fallos, en lugar de asumir un comportamiento estable. Quienes realizan la revisión humana pueden examinar entonces todo el recorrido, desde la entrada hasta el resultado, en condiciones documentadas.
Elige señales que revelen diferencias útiles
Una señal de calidad es una propiedad observable que ayuda a un equipo a comparar resultados o detectar riesgos. Las señales deben corresponderse con el cometido definido de la función. Un asistente de escritura puede necesitar fidelidad a las instrucciones y facilidad de edición, mientras que una función de clasificación puede necesitar límites claros entre categorías y una vía para gestionar los casos dudosos.
- Adecuación a la tarea: si el resultado respalda la decisión o acción prevista
- Correspondencia con las pruebas: si las afirmaciones importantes pueden verificarse con el material proporcionado
- Gestión de restricciones: si se respetan el formato, el alcance y las exclusiones exigidos
- Calidad de recuperación: si una corrección o aclaración produce un siguiente estado utilizable
- Demora de respuesta: si el tiempo de procesamiento sigue siendo aceptable para el flujo de trabajo diseñado
No es necesario convertir cada señal en una métrica automatizada. Algunas cualidades requieren una revisión humana estructurada, especialmente cuando varios resultados podrían ser aceptables. Una guía de revisión puede definir qué debe inspeccionarse y cómo registrar las preocupaciones sin fingir que los juicios subjetivos son perfectamente intercambiables. Las señales independientes suelen ofrecer un mejor diagnóstico que una etiqueta de calidad combinada.
Separa la calidad del modelo, del sistema y de la interacción
El resultado del modelo es solo una capa de una función de IA. La capa del sistema puede incluir un prompt, es decir, las instrucciones y el contexto enviados al modelo, además de la recuperación, que consiste en seleccionar el material de origen que se incluirá. La lógica del producto también puede validar formatos, restringir acciones o derivar un resultado para su revisión. Cuando resulte práctico, cada capa debe examinarse de forma independiente.
La capa de interacción determina qué contexto puede aportar una persona, qué estado es visible y cómo se realizan las correcciones. Un resultado deficiente puede deberse a una entrada incompleta, unos controles poco claros, una selección inadecuada de las fuentes o el modelo elegido. Rastrear el resultado a través de estas capas ayuda al equipo a modificar el componente adecuado, en lugar de ajustar repetidamente los prompts sin comprender el fallo.
Ejecuta un ciclo de evaluación controlado
Un ciclo controlado mantiene visibles las entradas, las reglas de revisión y los detalles de implementación mientras se evalúan los cambios. Si la implementación elegida puede producir resultados distintos en ejecuciones repetidas, la evaluación debe registrar esa condición y examinar si la variación afecta a la tarea. Las comparaciones solo son útiles cuando el equipo sabe qué ha cambiado entre ellas.
- Inmoviliza un conjunto de evaluación identificado por su nombre y documenta la cobertura prevista.
- Ejecuta la implementación actual mientras registras la configuración relevante y las condiciones de las fuentes.
- Revisa cada resultado según las señales definidas y asígnale un estado que permita actuar.
- Examina los fallos en las capas del modelo, del sistema y de la interacción antes de proponer un cambio.
- Repite los casos afectados y comprueba si el cambio introduce problemas en otras partes.
Estados como «aprobado», «revisar» y «bloqueado» pueden conectar la evaluación con las decisiones de producto sin implicar una certeza matemática. Los controles humanos deben especificar quién puede aprobar resultados sensibles, qué pruebas necesita quien los revisa y cómo se gestionan los resultados rechazados. Las comprobaciones automatizadas pueden respaldar este proceso cuando sus reglas son explícitas y sus limitaciones permanecen visibles.
Establece los límites de lanzamiento a partir de las pruebas
La evaluación debe concluir con una decisión acotada, no con una declaración general de que la IA es buena. Las pruebas pueden respaldar una tarea limitada, un intervalo de entradas más reducido, una revisión obligatoria o un diseño que solicite aclaraciones antes del procesamiento. Los casos sin resolver deben seguir identificados, en lugar de quedar absorbidos en una valoración media.
La secuencia práctica es sencilla: definir el cometido, reunir condiciones representativas, elegir señales de diagnóstico, inspeccionar cada capa del producto y repetir los cambios mediante un ciclo controlado. Los límites de lanzamiento pueden reflejar entonces lo que el equipo ha examinado realmente. A medida que cambien la función o sus dependencias, el mismo marco proporcionará una forma estable de decidir qué debe volver a comprobarse.